 English
 Nederlands
 Español


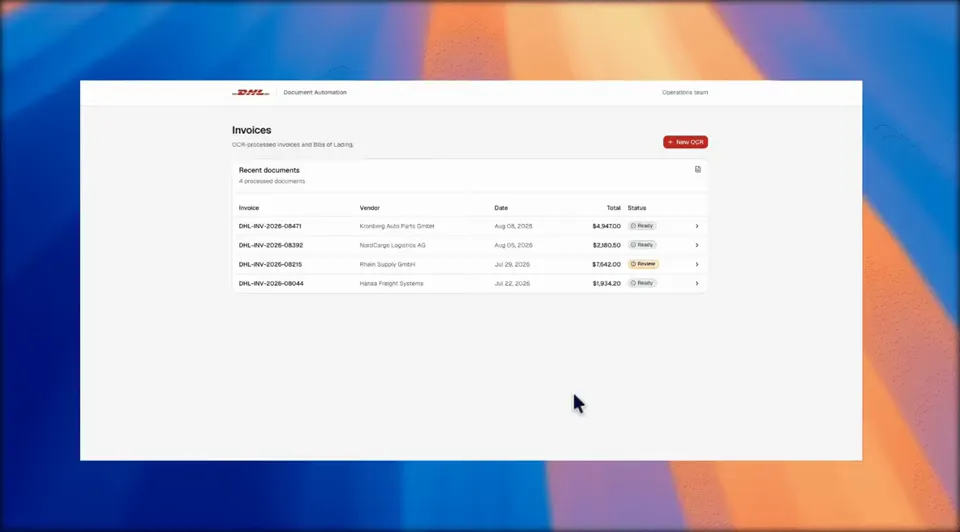
Een vrachtbrief bevat twintig velden. Een handelsfactuur bevat de velden waar de douane om geeft. Iemand leest ze allebei en typt ze over in een systeem dat ze direct had moeten ontvangen. Documentextractie haalt die stap eruit zonder het menselijk oordeel op te geven dat uitzonderingen nodig hebben.
Innemen, extraheren, plaatsen
- 01
Innemen
Documenten komen binnen zoals ze dat al doen — e-mailbijlagen, een scanner, een gedeelde map, een upload uit een klantportaal of een foto aan de balie.
Niemand hoeft de aanvoer van documenten te veranderen.
- 02
Extraheren
AI-OCR leest elk documenttype en geeft de velden terug die uw proces nodig heeft, met een betrouwbaarheidsscore per veld.
Indelingen die veranderen breken de flow niet, omdat het model inhoud leest in plaats van vaste coördinaten.
- 03
Plaatsen
Geëxtraheerde waarden worden tegen uw regels gevalideerd — bekende klanten, geldige artikelnummers, kloppende aantallen — en in uw TMS, ERP, facturatie of douaneaangifte geplaatst, met het originele document als audittrail.
Wat u krijgt
- Vrachtbrieven, handelsfacturen, paklijsten, afleverbonnen en CMR-documenten
- Betrouwbaarheidsscores per veld, zodat twijfelgevallen naar een mens gaan en niet naar de database
- Validatie tegen uw masterdata voordat er iets wordt geplaatst
- Gestructureerde output voor TMS, ERP en douaneaangiften, inclusief EUCDM XML
Welke documenten en welke velden
We beginnen bij de documenten die per zending de meeste tijd kosten, niet bij de meest indrukwekkende demo. In expeditie en douane zijn dat meestal de vrachtbrief, de handelsfactuur en de paklijst, met afleverbonnen en CMR's daar vlak achter.
De veldenlijst is van u: wij extraheren wat uw proces stroomafwaarts echt gebruikt, zodat de output geplaatst kan worden zonder dat iemand hem herformatteert.
Velden die we doorgaans teruggeven
- Zendingidentificatie: B/L-nummer, boeking, container- en zegelnummers
- Partijen: afzender, geadresseerde, notify party, vervoerder, met adressen als aparte velden
- Goederen: omschrijvingen, artikelnummers, aantallen, eenheden, gewichten, colli
- Commercieel: factuurnummer en -datum, valuta, waarden, Incoterms, land van herkomst
Nauwkeurigheid, uitzonderingen en de mens in de lus
Extractie is nooit alles-of-niets. Elk veld komt terug met een betrouwbaarheidsscore; waarden onder uw drempel gaan naar een controlelijst met het brondocument ernaast, zodat iemand één veld corrigeert in plaats van twintig te typen.
Die controlelijst is ook waar het model beter wordt: correcties worden vastgelegd, zodat terugkerende indelingen van leveranciers op den duur geen uitzonderingen meer opleveren.
- Instelbare drempels per documenttype en per veld
- Controlelijst met document en geëxtraheerde waarden naast elkaar
- Correcties worden teruggevoerd, zodat terugkerende uitzonderingen verdwijnen
- Volledige audittrail: origineel document, geëxtraheerde waarden, wie wat goedkeurde
Van document naar douaneaangifte
Voor douanewerk is extractie de helft van de klus. De waarden moeten ook landen in een aangifte die een douaneautoriteit accepteert, in de structuur die die autoriteit verwacht.
Wij bouwen de mapping van geëxtraheerde velden naar aangiftegegevens, inclusief EUCDM XML, zodat een document dat 's ochtends binnenkomt dezelfde dag aangegeven kan worden zonder tussenstap waarin iemand opnieuw typt.
- Mapping van geëxtraheerde velden naar uw aangiftestructuur
- EUCDM XML-output voor douaneprocedures
- HS-codes en land van herkomst gaan mee in plaats van opnieuw ingetypt
- Integratie met de systemen waarmee u al aangeeft
Veelgestelde vragen
Hoe nauwkeurig is de extractie in de praktijk?
Op de documentflow van DHL Aruba draaien we op 96%+ extractienauwkeurigheid met ongeveer vier minuten verwerkingstijd per document. Nauwkeurigheid hangt af van documentkwaliteit, dus we meten het op uw eigen voorbeelden voordat we een getal toezeggen.
Wat gebeurt er als een leverancier de indeling van zijn document wijzigt?
Er breekt niets. De modellen lezen inhoud in plaats van vaste coördinaten, dus een nieuwe indeling wordt als elk ander document behandeld. Als een veld structureel niet meer gevonden wordt, verschijnt het in de controlelijst en passen we de velddefinitie aan.
Moeten we documenten ergens anders naartoe sturen?
Nee. De verwerking loopt binnen de flow die u al heeft — documenten komen binnen via e-mail, scanner, gedeelde map of upload, en het gestructureerde resultaat gaat terug naar uw eigen systemen. Wij hoeven uw documenten niet onder ons beheer te hebben.
Kan het naar ons aangiftesysteem outputten?
Ja, inclusief EUCDM XML waar de aangifte dat vereist. Wij bouwen de mapping van geëxtraheerde velden naar de aangiftestructuur waarmee u indient.
Kunnen we met één documenttype beginnen?
Dat is de aanbevolen start. Eén documenttype, één systeem stroomafwaarts, gemeten nauwkeurigheid — daarna breiden we uit naar het volgende document zodra de eerste flow in productie bewezen is.
De andere datacapaciteiten
Vastleggen, extraheren en communiceren vormen samen één pijplijn. De meeste operaties beginnen waar de pijn het grootst is en breiden daarvandaan uit.
Stuur ons het document dat u de meeste tijd kost.
Een vrachtbrief, een factuur, een paklijst — alles wat iemand nu handmatig intypt. Wij laten het door de extractieflow lopen en tonen u de velden die terugkomen, met de betrouwbaarheidsscores erbij.
Gerelateerd werk
Case studies